요즘 AI 관련 자료를 보다 보면 ‘온톨로지(Ontology)’라는 단어를 생각보다 자주 만나게 됩니다.
처음 보면 이름부터 조금 어렵습니다.
철학 용어 같기도 하고, 데이터베이스나 AI 기술 같기도 합니다.
실제로 둘 다 맞습니다.

온톨로지는 원래 철학에서 ‘무엇이 존재하는가’를 다루던 개념입니다.
그런데 컴퓨터 분야에서는 조금 다른 의미로 사용됩니다.
간단히 말하면 어떤 분야에 존재하는 것들을 정의하고,
그것들이 서로 어떤 관계를 가지고 있는지 정리한 구조입니다.
저는 처음 온톨로지를 볼 때 ‘지식의 설계도’라고 생각하니 이해하기 조금 편했습니다.
예를 들어 쇼핑몰을 하나 만든다고 해보겠습니다.
쇼핑몰에는 상품이 있고, 상품에는 노트북이나 스마트폰 같은 종류가 있습니다.
노트북에는 제조사, 운영체제, 가격 같은 정보도 들어갑니다.
단순한 데이터베이스라면 이런 값을 저장하는 데 집중합니다.
하지만 온톨로지는 한 단계 더 나아갑니다.
노트북은 전자제품의 한 종류이고, 특정 회사가 노트북을 제조하며, 노트북에는 운영체제가 설치될 수 있다는 식으로
정보 사이의 의미까지 정의합니다.
그래서 단순히 단어를 모아놓은 사전과는 조금 다릅니다.
온톨로지에는 무엇이 들어갈까?
온톨로지를 구성하는 요소는 크게 어렵지 않습니다.
먼저 개념(Class)이 있습니다.
예를 들어 병원 시스템이라면 사람, 환자, 의사, 질병, 약 같은 개념을 만들 수 있습니다.
그리고 실제 대상을 나타내는 인스턴스(Instance)가 있습니다.
‘사람’이라는 개념이 있다면 김민수라는 실제 사람이 인스턴스가 될 수 있습니다.
여기에 대상이 가진 정보를 나타내는 속성도 있습니다.
사람이라면 이름이나 생년월일을 가질 수 있고, 책이라면 제목이나 출판일 같은 정보를 가질 수 있습니다.
그리고 온톨로지에서 가장 중요한 부분 중 하나가 관계(Relationship)입니다.
예를 들면 이런 식입니다.
의사는 환자를 진료한다.
저자는 책을 쓴다.
회사는 제품을 생산한다.
사람은 회사에 근무한다.
이렇게 관계가 만들어지면 각각 떨어져 있던 데이터가 하나의 구조로 연결됩니다.
그냥 분류하는 것과 뭐가 다를까?
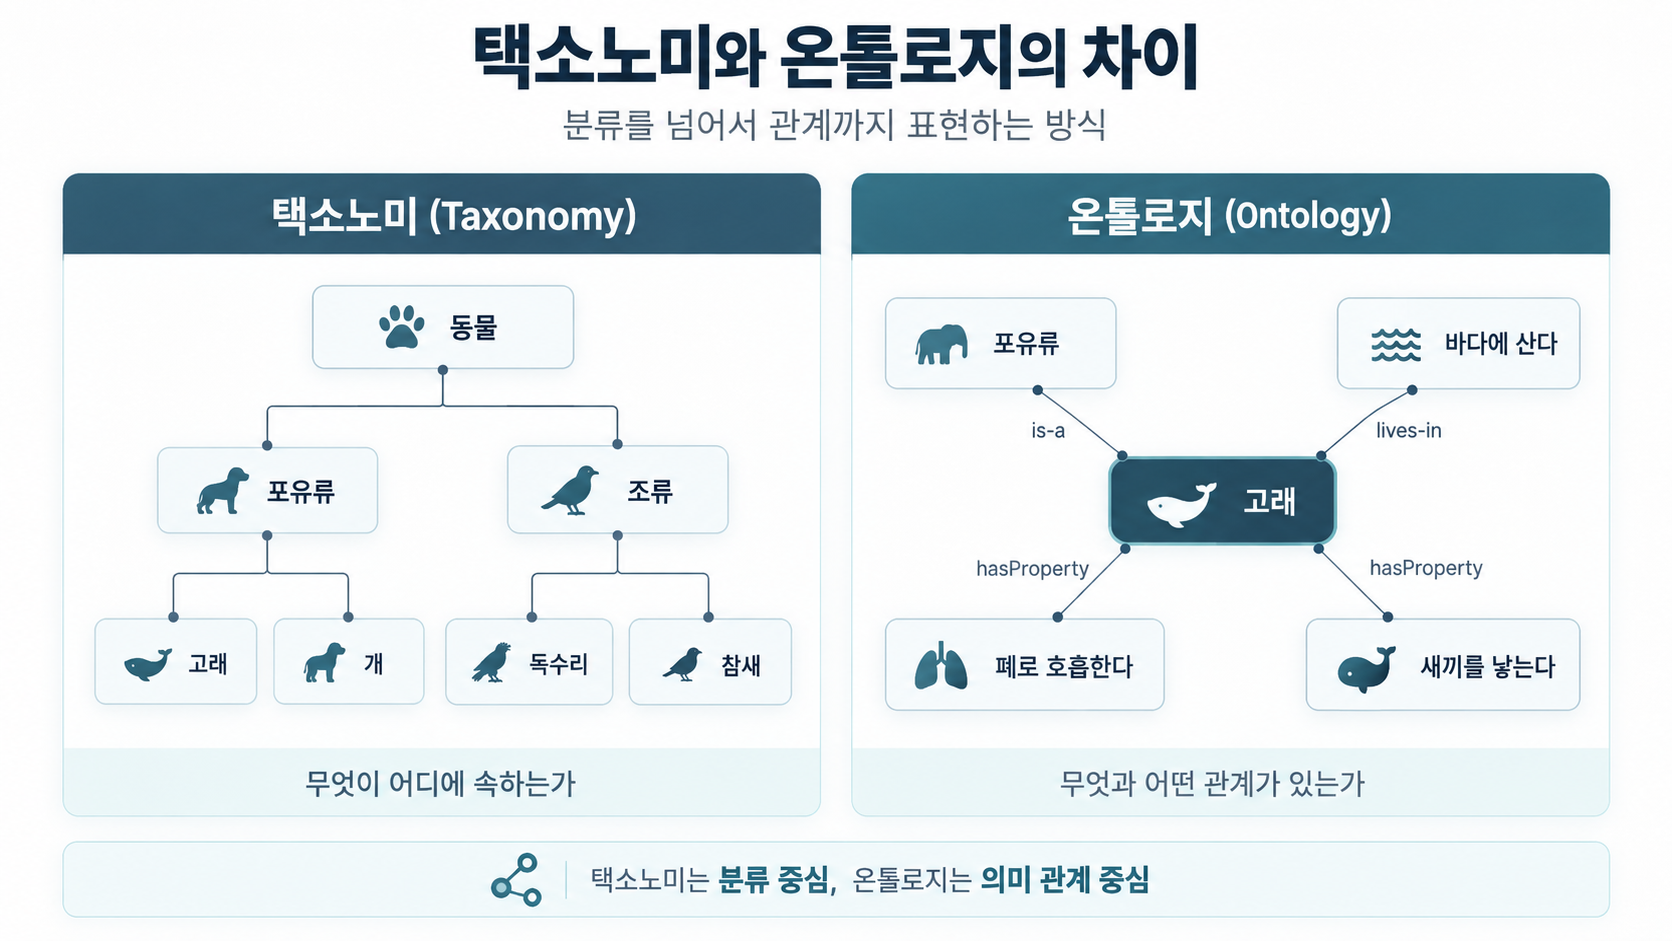
여기서 조금 헷갈리는 개념이 있습니다.
바로 ‘분류 체계(Taxonomy)’입니다.
예를 들어
동물 → 포유류 → 고래
처럼 상하 관계로 정리하는 것이 대표적인 분류 구조입니다.
온톨로지도 이런 구조를 사용할 수 있지만 여기서 끝나지 않습니다.
고래는 포유류다.
고래는 바다에 산다.
고래는 폐로 호흡한다.
이처럼 여러 종류의 관계를 함께 표현할 수 있습니다.
그래서
분류 체계가 주로 ‘어디에 속하는가’를 설명한다면,
온톨로지는 ‘무엇과 어떤 관계가 있는가’까지 표현한다고 보면 됩니다.
AI에서는 왜 온톨로지를 사용할까?
온톨로지가 AI 분야에서 사용되는 이유도 결국 ‘의미’ 때문입니다.
컴퓨터 입장에서는 같은 단어라도 어떤 의미인지 바로 판단하기 어려운 경우가 많습니다.
대표적인 예가 ‘Java’입니다.
Java는 프로그래밍 언어일 수도 있고 인도네시아의 자바섬을 의미할 수도 있습니다.
주변에 프로그래밍, 개발, JVM 같은 개념이 연결되어 있다면 프로그래밍 언어 Java일 가능성이 높습니다.
반대로 인도네시아, 여행, 섬 같은 개념과 연결되어 있다면 장소를 의미할 가능성이 큽니다.
이렇게 개념과 관계를 함께 가지고 있으면 단순한 문자열 검색보다 데이터의 의미를 좀 더 명확하게 다룰 수 있습니다.
서로 다른 시스템의 데이터를 연결할 때도 유용합니다.
예를 들어 어떤 시스템에서는 ‘고객’이라고 저장하고 다른 시스템에서는 ‘회원’이라고 저장했다고 해보겠습니다.
사람은 둘을 비슷하게 이해하지만 컴퓨터에서는 그냥 서로 다른 문자열입니다.
온톨로지를 이용하면 두 단어가 같은 개념인지, 비슷하지만 다른 개념인지 미리 정의할 수 있습니다.
온톨로지로 추론도 할 수 있다
개인적으로 온톨로지에서 가장 재미있는 부분은 이 부분이었습니다.
이미 저장된 정보를 이용해서 새로운 정보를 알아낼 수 있습니다.
예를 들어
모든 포유류는 동물이다.
고래는 포유류다.
라는 규칙이 있다면,
‘고래는 동물이다.’
라는 정보를 따로 입력하지 않아도 시스템이 관계를 따라가며 알아낼 수 있습니다.
이런 과정을 ‘추론(Reasoning)’이라고 합니다.
물론 실제 시스템에서는 이것보다 훨씬 복잡한 규칙을 사용할 수 있습니다.
지식 그래프와는 뭐가 다를까?

온톨로지를 찾아보다 보면 지식 그래프(Knowledge Graph)라는 말도 거의 같이 등장합니다.
둘은 상당히 밀접하게 연결되어 있습니다.
아주 단순하게 구분하면
온톨로지는 구조를 정의하는 설계도,
지식 그래프는 그 설계도에 실제 데이터를 넣어 만든 구조라고 생각하면 이해하기 편합니다.
예를 들어
사람 → 회사에 근무한다 → 회사
라는 관계를 정의하는 것이 온톨로지라면,
김민수 → 회사에 근무한다 → A회사
처럼 실제 데이터를 연결한 것이 지식 그래프입니다.
다만 실제 기술에서는 두 영역이 명확하게 구분되지 않는 경우도 많습니다.
RDF와 OWL
온톨로지를 실제 컴퓨터에서 표현하기 위한 기술도 있습니다.
대표적으로 RDF, RDFS, OWL이 있습니다.
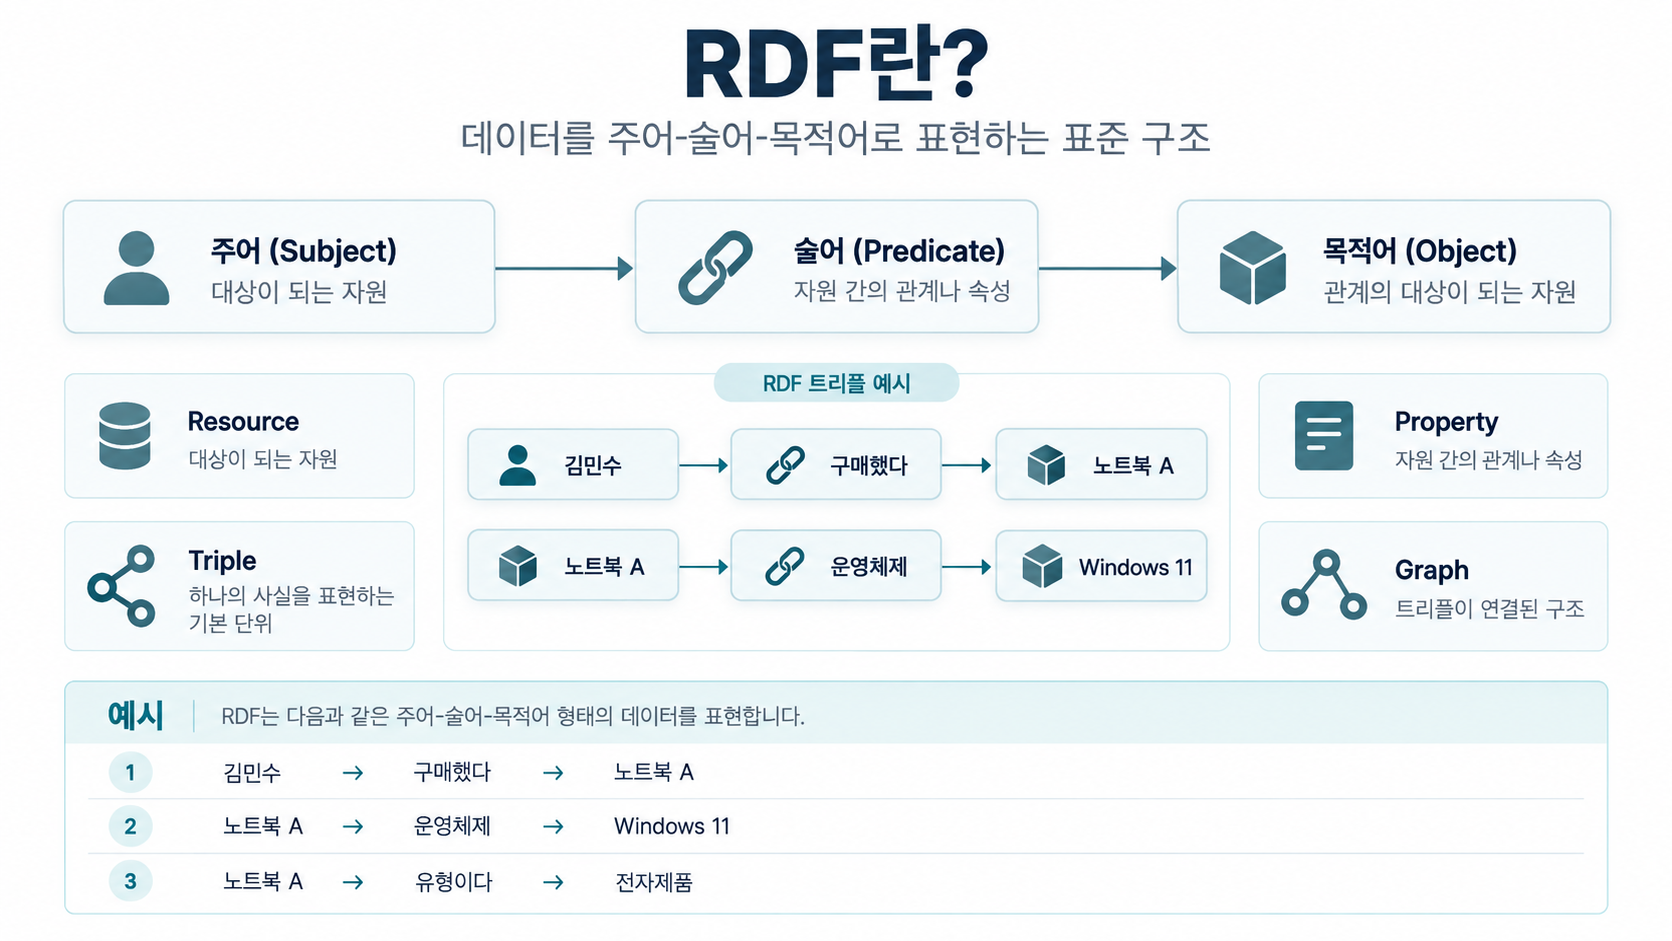
RDF는 정보를 아주 단순한 형태로 표현합니다.
예를 들어
김민수 → 작성했다 → 책A
처럼
‘주어 - 관계 - 대상’
구조로 데이터를 표현합니다.
이 구조를 Triple이라고 부릅니다.
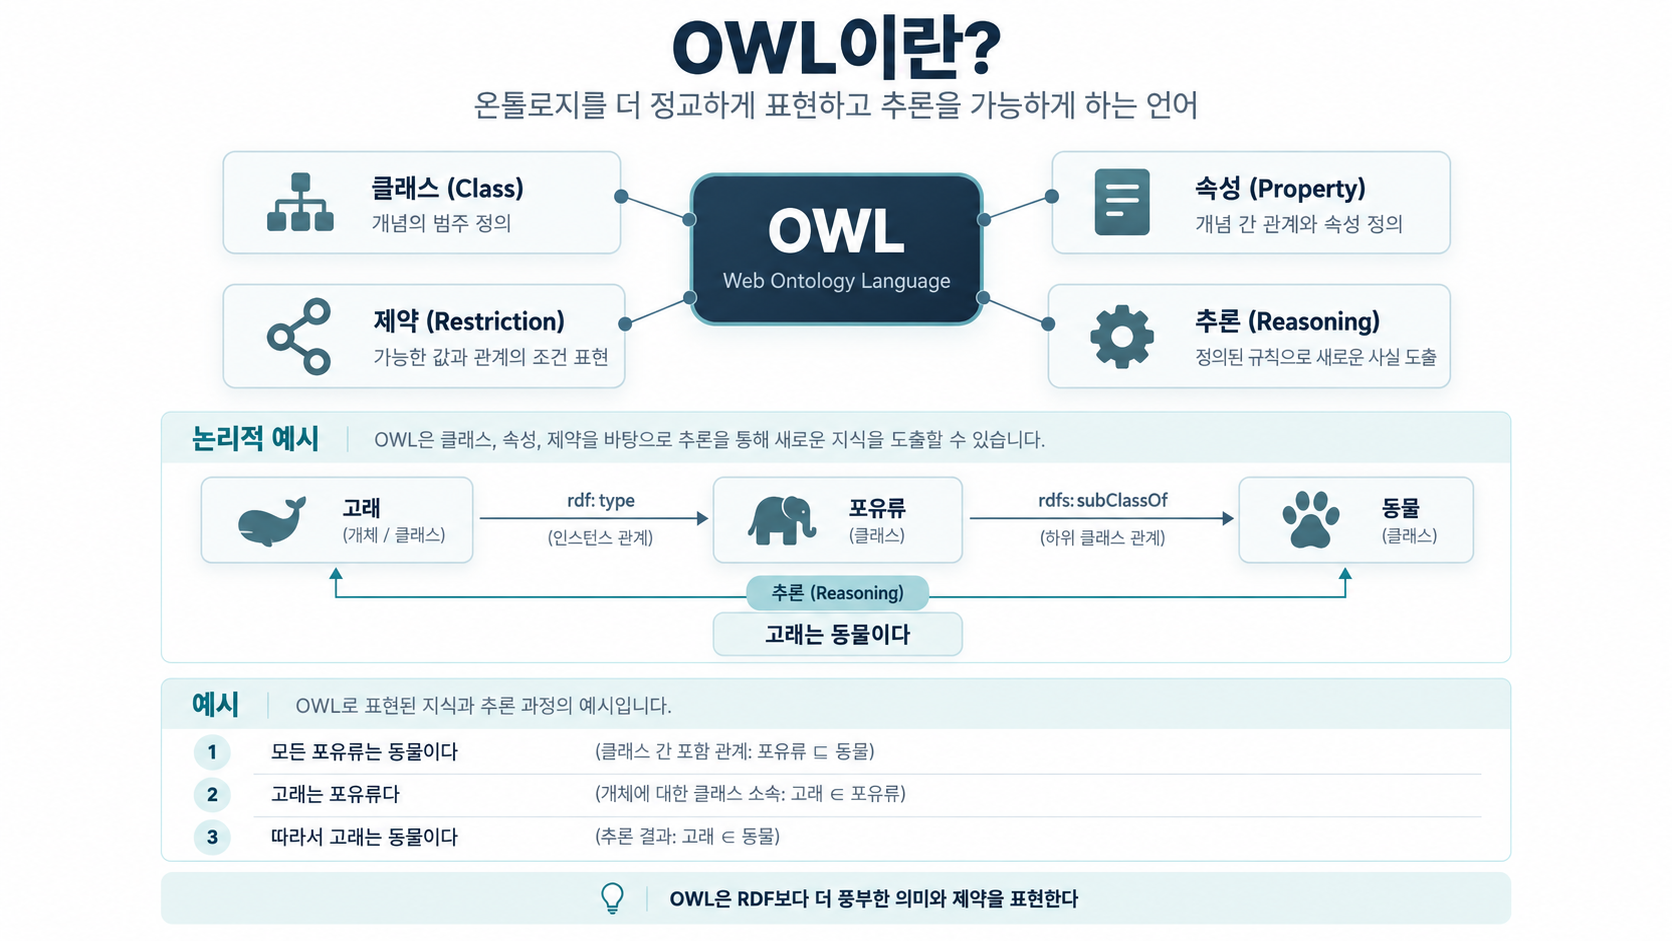
OWL은 여기에서 조금 더 나아가 클래스 관계나 논리적인 규칙까지 상세하게 표현할 수 있도록 만든 언어입니다.
처음 온톨로지를 공부한다면 RDF나 OWL 문법부터 보는 것보다 먼저 개념과 관계를 어떻게 설계하는지 이해하는 편이 훨씬 쉽습니다.
작은 온톨로지를 한번 만들어보자
도서관을 예로 들어보겠습니다.
먼저 필요한 개념을 생각합니다.
도서관
책
회원
저자
대출
그리고 관계를 연결합니다.
저자는 책을 쓴다.
도서관은 책을 보유한다.
회원은 책을 대출한다.
여기서 실제 데이터를 넣으면
김민수 → 회원이다 → A도서관
김민수 → 대출했다 → 책A
같은 구조가 만들어집니다.
처음에는 이 정도로 시작해도 충분합니다.
온톨로지를 처음부터 현실 세계와 똑같이 만들려고 하면 구조가 금방 복잡해집니다.
결국 중요한 것은 무엇을 표현하려는지 먼저 정하는 것입니다.
결국 온톨로지는
온톨로지를 한 문장으로 설명한다면 저는 이렇게 정리하고 싶습니다.
컴퓨터가 데이터의 의미와 데이터 사이의 관계를 이해할 수 있도록 만들어 놓은 지식 구조.
단순히 데이터를 저장하는 것이 아니라
이 데이터가 무엇이고,
다른 데이터와 어떤 관계가 있으며,
그 관계를 통해 무엇을 알 수 있는지까지 표현하는 것입니다.
최근에는 LLM이나 RAG, 지식 그래프와 함께 온톨로지가 다시 자주 언급되고 있습니다.
LLM이 문장을 굉장히 잘 다루더라도 회사 내부의 ‘제품’, ‘고객’, ‘조직’, ‘장비’가
정확히 어떤 의미인지 처음부터 알고 있는 것은 아니기 때문입니다.
이런 데이터를 명확한 관계로 정리해 놓으면 AI가 내부 정보를 검색하거나 연결해서 사용하는 데 도움이 됩니다.
그래서 온톨로지를 이해하고 나면
지식 그래프나 Knowledge Graph RAG 같은 기술을 볼 때도 훨씬 이해하기 쉬워집니다.
'공부' 카테고리의 다른 글
| YOLO를 공부하기 전에 알아야 할 상식과 기초 지식 2편: IoU부터 mAP와 NMS까지 (0) | 2026.09.17 |
|---|---|
| YOLO 공부 전 필수 기초 1편: 이미지 픽셀, 바운딩 박스, 클래스, 학습 데이터 이해하기 (0) | 2026.09.16 |
| 객체 추적(Object Tracking) 알고리즘이란? 탐지부터 ID 유지까지 쉽게 이해하기 (0) | 2026.09.16 |
| 도커로 ROS 2가 동작하는 원리와 Cyclone DDS 네트워크 이해하기 (0) | 2026.09.14 |
| MLOps란? 머신러닝 모델을 안정적으로 운영하는 방법 (0) | 2026.09.12 |